triattention
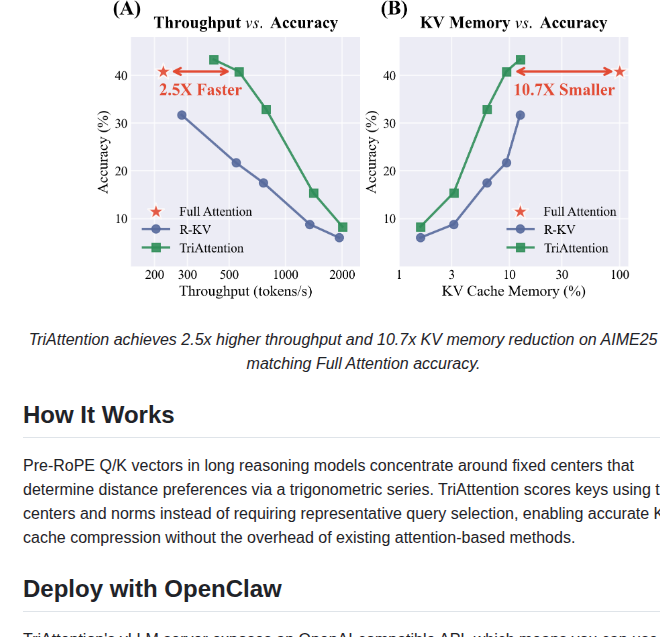
TriAttention — метод сжатия кэша "ключ-значение" (KV-кэша) для больших языковых моделей, предназначенный для повышения эффективности обработки длинных последовательностей. Он ориентирован на разработчиков и исследователей, работающих с моделями, требующими обработки больших объемов данных, и может быть полезен для оптимизации использования памяти и пропускной способности.
Проект использует тригонометрическое сжатие KV-кэша, что позволяет сократить его размер. TriAttention интегрируется с vLLM и SGLang, а также официально поддерживается в NVIDIA TensorRT-LLM, что обеспечивает его применение в различных средах. Метод позволяет использовать модели с большими контекстными окнами на оборудовании с ограниченным объемом памяти.
Для работы TriAttention требуется Python 3.10 или выше. Проект поддерживает такие модели, как Qwen3-8B, DeepSeek-R1-Distill-Llama-8B и DeepSeek-R1-Distill-Qwen-7B. Для использования необходимы предварительно рассчитанные статистические данные Q/K частот, которые можно сгенерировать для пользовательских моделей. TriAttention также имеет экспериментальную поддержку Apple Silicon (M1/M2/M3/M4) через MLX.
triattention на GitHub · 858 звёзд