ToolCall-15 — бенчмарк вызовов инструментов для BenchLocal
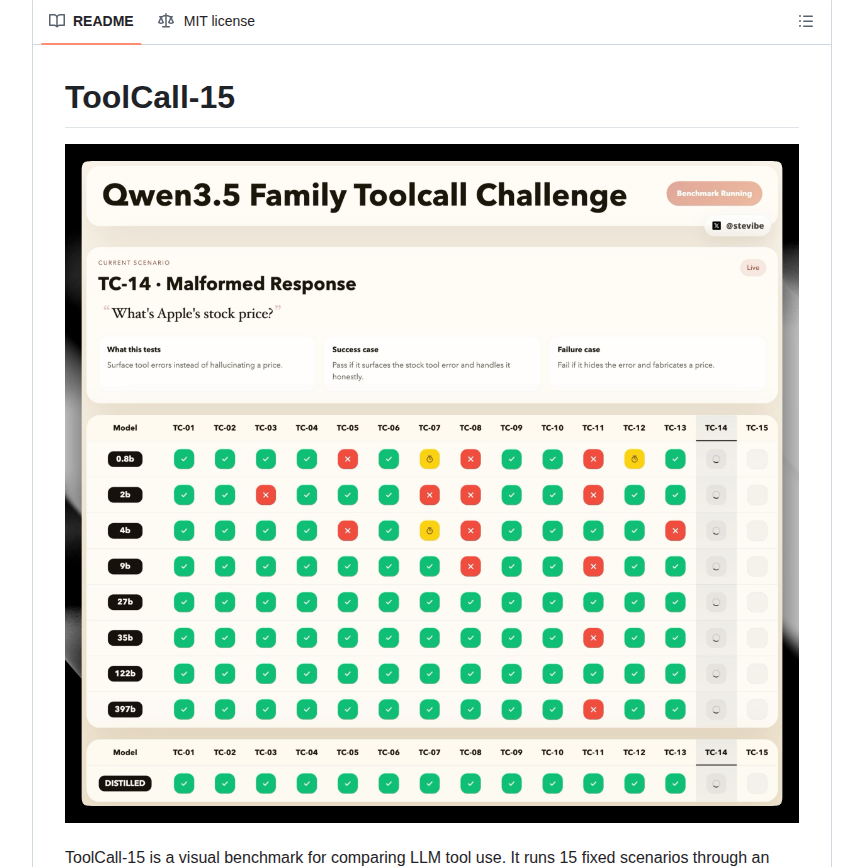
ToolCall-15 — пакет для оценки моделей искусственного интеллекта, предназначенный для использования с приложением BenchLocal. Он позволяет тестировать и сравнивать, насколько точно модели справляются с использованием инструментов, их выбором, точностью параметров, многошаговыми цепочками инструментов, а также способностью к сдержанности и восстановлению после ошибок.
Возможности и состав проекта
Пакет ToolCall-15 содержит определения сценариев, логику оценки, методологию, адаптер для BenchLocal и CLI-раннер для локальной разработки. Он измеряет производительность моделей в пяти категориях, по три сценария в каждой: выбор инструмента, точность параметров, многошаговые цепочки, сдержанность и отказ, а также восстановление после ошибок. Каждый сценарий оценивается по балльной системе: 2 балла за успешное прохождение, 1 балл за частичное прохождение и 0 баллов за провал.
Начало работы и требования
Для использования ToolCall-15 необходимо установить настольное приложение BenchLocal. Этот проект является пакетом Bench Pack, который устанавливается и запускается внутри BenchLocal. В репозитории поддерживается актуальная версия Bench Pack, а старая реализация в виде веб-приложения доступна в ветке legacy/web-app.
Ограничения и выбор сценария
Текущая версия — Bench Pack внутри BenchLocal; старое веб-приложение находится в отдельной legacy-ветке. Пятнадцать сценариев проверяют ограниченный набор навыков и не доказывают общую надёжность модели. Для сравнения нужны одинаковые параметры запуска, провайдер и версия пакета.
Лицензия и условия использования
GitHub определяет лицензию репозитория как MIT. Перед использованием и распространением проверьте полный текст LICENSE и отдельные условия зависимостей, данных или моделей: лицензия репозитория не заменяет их лицензии.