MagiCompiler — компиляция и оптимизация Transformer-моделей
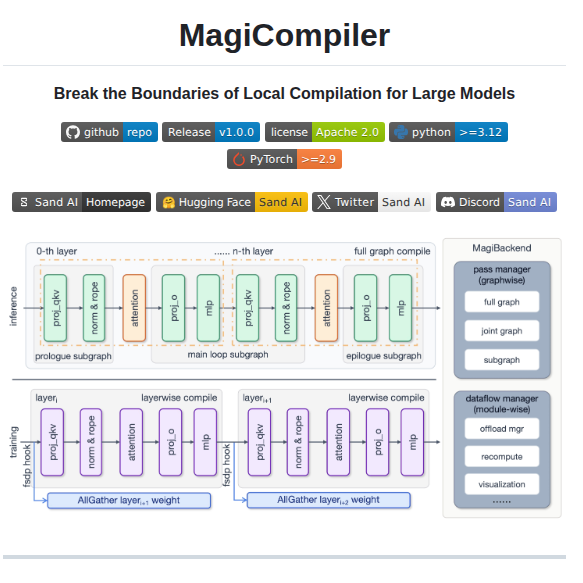
MagiCompiler — фреймворк для компиляции и оптимизации времени выполнения, основанный на torch.compile. Он предназначен для ускорения работы больших моделей архитектуры Transformer, преодолевая ограничения памяти и накладные расходы операторов. Проект предлагает системные оптимизации для обучения и многомодального инференса.
Возможности и состав проекта
Для инференса MagiCompiler захватывает полный граф вычислений, увеличивая область слияния ядер. Для обучения он предлагает компиляцию с учётом FSDP (Fully Sharded Data Parallel), что позволяет агрессивно объединять операции. Фреймворк также включает асинхронную выгрузку данных для систем с ограниченной памятью и эвристическую перекомпиляцию активаций, которая сокращает пиковое потребление памяти.
Начало работы и требования
Для использования MagiCompiler требуется Python версии 3.12 или выше, PyTorch версий 2.9.x или 2.12.x, а также CUDA Toolkit. Рекомендуется начать с предварительно собранного образа Docker для воспроизводимости. Проект находится в активной разработке, планируются дальнейшие интеграции с фреймворками и усовершенствования.
Ограничения и выбор сценария
Ускорение зависит от модели, формы входов, GPU и стоимости начальной компиляции. Захват полного графа и FSDP-оптимизации нельзя считать совместимыми с произвольным PyTorch-кодом. Сначала сравните численные результаты и потребление памяти с исходным режимом. Пример Docker в README использует расширенные привилегии и общие пространства имён; для своего сервера эти права нужно обосновать отдельно. Заявление free-lunch не отменяет проверки корректности и воспроизводимости.
Лицензия и условия использования
GitHub определяет лицензию репозитория как Apache-2.0. Перед использованием и распространением проверьте полный текст LICENSE и отдельные условия зависимостей, данных или моделей: лицензия репозитория не заменяет их лицензии.