NanoGPT Slowrun
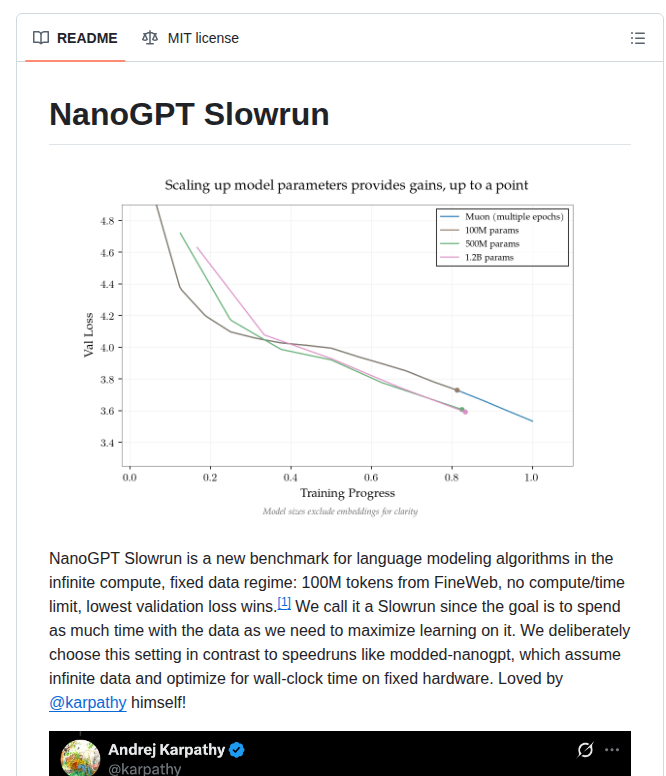
NanoGPT Slowrun — бенчмарк алгоритмов языкового моделирования с фиксированным объёмом данных: 100 миллионов токенов FineWeb. Он сравнивает подходы в нескольких режимах вычислительного бюджета, включая трек без ограничения времени.
Проект предлагает четыре трека с различными ограничениями по времени и вычислительным ресурсам: 15 минут, 1 час, 2 часа на одном узле с 8xH100, а также трек без ограничений. Для каждого трека предоставляются скрипты, позволяющие воспроизвести текущие рекордные результаты. В таблицах рекордов зафиксированы улучшения валидационных потерь, достигнутые благодаря различным архитектурным решениям, таким как использование активации Swiglu или архитектуры U-Net.
Для запуска и воспроизведения результатов требуется установка зависимостей через pip и подготовка данных с помощью скрипта prepare_data.py. Обучение моделей осуществляется с использованием torchrun на 8 процессах. Проект предполагает активное участие сообщества через отправку запросов на слияние с новыми рекордными показателями потерь валидации.
https://github.com/qlabs-eng/slowrun | 564 звезды
#сервисы