SatoriDB — встраиваемый векторный поиск с хранением на диске
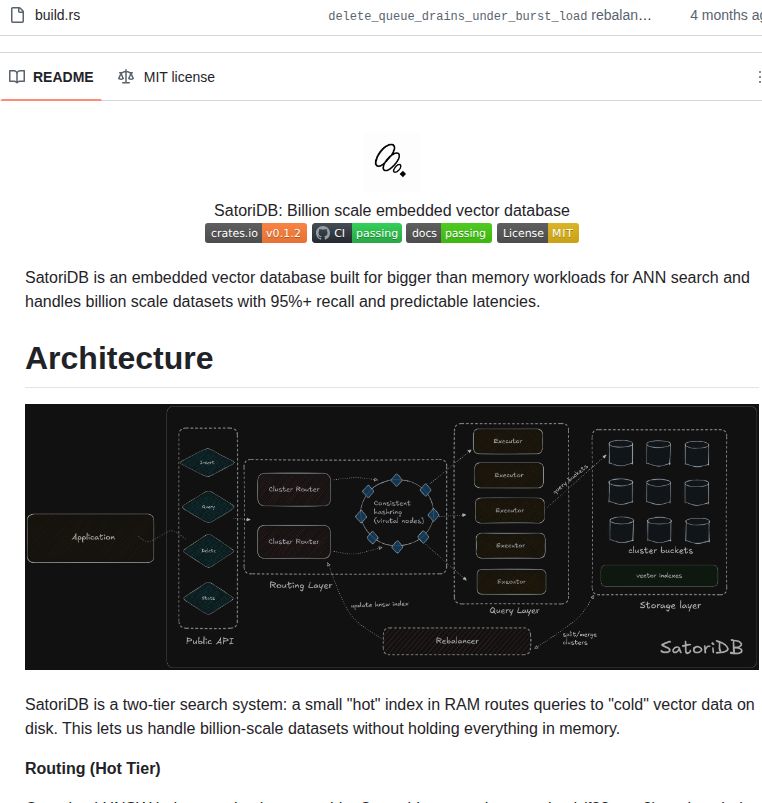
SatoriDB — встраиваемая векторная база данных для поиска ближайших соседей в наборах, которые не помещаются целиком в оперативную память. Проект использует совместное хранение индекса в RAM и векторных данных на диске.
Возможности и состав проекта
Индекс HNSW в оперативной памяти направляет запросы к дисковым кластерам векторов. Для группировки используется k-means, а фоновая перебалансировка разделяет кластеры при превышении заданного размера. Такая организация ориентирована на работу с наборами, превышающими объём RAM.
Начало работы и требования
SatoriDB работает только под Linux, так как требует io_uring и ядро версии 5.8 или новее. Проект находится на ранней стадии разработки (версия 0.1.2), и API может изменяться между версиями. Для использования необходимо добавить зависимость satoridb в проект на Rust.
Ограничения и выбор сценария
SatoriDB использует приближённый поиск: полноту выдачи и задержки нужно измерять на собственных векторах и диске. Архитектура уменьшает потребность держать весь набор в RAM, но оставляет в памяти маршрутизирующий индекс и рабочие буферы. README указывает Linux с io_uring; ранний API и интервал fsync требуют отдельной проверки совместимости и допустимого риска потери последних записей. Параметры кластера и частота синхронизации диска влияют на компромисс между скоростью, качеством выдачи и сохранностью записей.
Лицензия и условия использования
GitHub определяет лицензию репозитория как MIT. Перед использованием и распространением проверьте полный текст LICENSE и отдельные условия зависимостей, данных или моделей: лицензия репозитория не заменяет их лицензии.