MMMU Benchmark — оценка мультимодальных моделей по дисциплинам
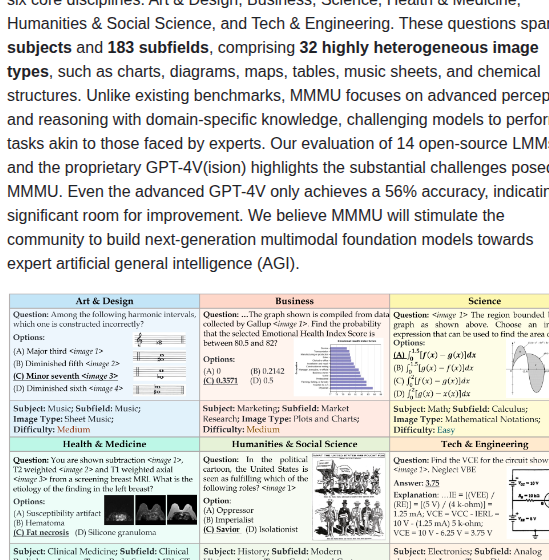
MMMU Benchmark — набор данных и код для оценки мультимодальных моделей. Он предназначен для проверки возможностей моделей в понимании и интерпретации сложной информации из различных областей знаний, требующих междисциплинарных знаний и рассуждений на уровне колледжа.
Возможности и состав проекта
MMMU содержит около 11,5 тысячи вопросов по шести дисциплинам и 30 предметам. Отдельная версия MMMU-Pro усложняет оценку, фильтруя задания, решаемые только по тексту, и меняя варианты ответов и визуальное представление. Репозиторий даёт код оценки и ссылки на соответствующие наборы; результаты разных версий следует указывать раздельно.
Начало работы и требования
Для оценки моделей можно использовать предоставленный код и набор данных. Ответы для тестового набора MMMU доступны для локальной оценки. Также существует интеграция с EvalScope, которая предоставляет сторонний рабочий процесс для запуска MMMU с моделями, совместимыми с OpenAI, и генерирует отчеты об оценке.
Ограничения и выбор сценария
Балл отражает выполнение конкретного набора задач и протокола, а не универсальный уровень экспертности или AGI. Для сравнения моделей фиксируйте split, промпт, обработку изображений и разбор ответов. Открытые ответы тестового набора повышают риск утечки в обучение; условия исходных материалов и датасета проверяются отдельно от Apache-2.0 кода оценки.
Лицензия и условия использования
GitHub определяет лицензию репозитория как Apache-2.0. Перед использованием и распространением проверьте полный текст LICENSE и отдельные условия зависимостей, данных или моделей: лицензия репозитория не заменяет их лицензии.