LayoutParser — анализ макета документов и интеграция OCR
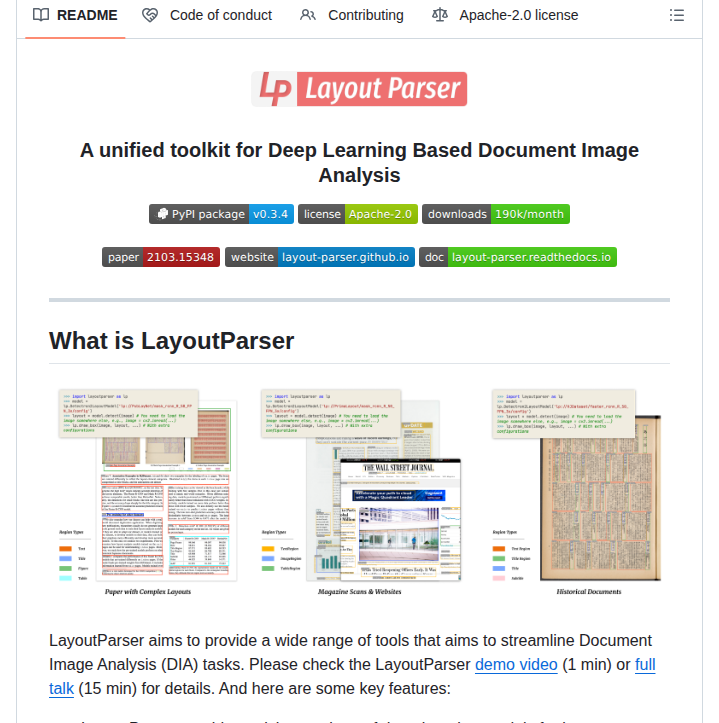
LayoutParser — библиотека для анализа изображений документов с использованием методов глубокого обучения. Она предназначена для автоматизации задач извлечения информации из документов, таких как обработка сканированных текстов.
Возможности и состав проекта
Проект предлагает готовые модели глубокого обучения для обнаружения элементов макета документа и унифицированные программные интерфейсы для их использования. Он включает структуры данных для работы с макетами и текстовыми элементами, функции для оптического распознавания символов в выделенных областях и инструменты для визуализации обнаруженных макетов. Поддерживается загрузка данных макета из файлов JSON, CSV и PDF.
Начало работы и требования
Для установки базовой библиотеки LayoutParser используется команда pip install layoutparser. Дополнительные функции, такие как модели глубокого обучения для анализа макета и инструменты оптического распознавания символов, устанавливаются командами pip install "layoutparser[layoutmodels]" и pip install "layoutparser[ocr]" соответственно. Для моделей на базе Detectron2 требуются дополнительные шаги установки.
Ограничения и выбор сценария
Обнаружение блоков и распознавание текста являются отдельными этапами: установка базового пакета не включает все модели и OCR-backend. Detectron2 требует дополнительной настройки. Предобученная разметка зависит от типа документа; для нестандартных сканов, таблиц или языков нужно оценить качество на своих примерах. Облачные OCR-интеграции также могут требовать ключей и передачи изображений внешнему сервису.
Лицензия и условия использования
GitHub определяет лицензию репозитория как Apache-2.0. Перед использованием и распространением проверьте полный текст LICENSE и отдельные условия зависимостей, данных или моделей: лицензия репозитория не заменяет их лицензии.