VisionFusion AI — модульный конвейер анализа изображений и видео
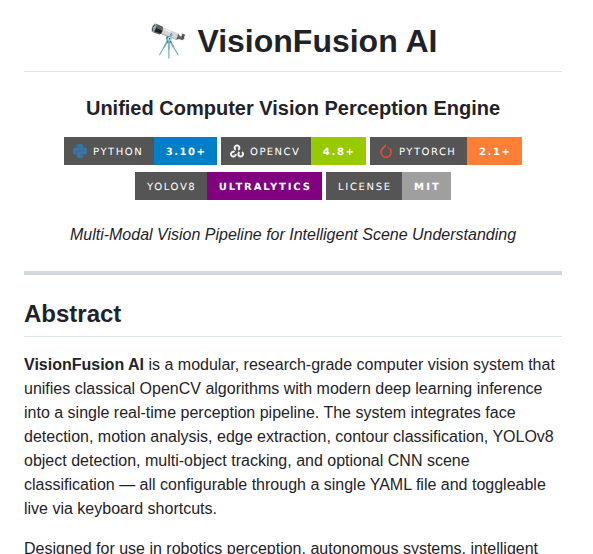
VisionFusion AI — модульная система компьютерного зрения, объединяющая классические алгоритмы OpenCV с методами глубокого обучения. Она предназначена для использования в робототехнике, автономных системах, интеллектуальном видеонаблюдении и исследованиях в области визуального ИИ, предоставляя единый конвейер для анализа изображений и видео.
Возможности и состав проекта
Система включает такие функции, как обнаружение лиц, анализ движения, выделение контуров, классификация контуров, обнаружение объектов с помощью YOLOv8 и многообъектное отслеживание. Все модули настраиваются через единый YAML-файл, а их работу можно переключать в реальном времени с помощью горячих клавиш. Дополнительно поддерживается классификация сцен с использованием CNN.
Начало работы и требования
README указывает Python 3.10+, зависимости из requirements.txt и настройку YAML. Основной детектор — YOLOv8 через Ultralytics; YOLOv3/SSD оставлены как legacy-путь с отдельными весами. Начните с нужного модуля и одного видеоисточника, затем подключайте tracking и классификацию, проверяя расход ресурсов и фактический вывод.
Ограничения и выбор сценария
Real-time в описании не гарантирует частоту при любой комбинации модулей и разрешении. Детекция лица не равна установлению личности, а tracking может терять объект и менять его идентификатор. Для практического применения нужны оценки на собственных данных и контроль прав доступа к видеопотоку. MIT репозитория не заменяет лицензии Ultralytics, весов и датасетов; одинаковый YAML-интерфейс не делает все backend взаимозаменяемыми по качеству.
Лицензия и условия использования
GitHub определяет лицензию репозитория как MIT. Перед использованием и распространением проверьте полный текст LICENSE и отдельные условия зависимостей, данных или моделей: лицензия репозитория не заменяет их лицензии.