Как обычно выглядит разработка собственного ИИ-продукта у каждого стартапа
__Сохраняйте себе инструкцию__
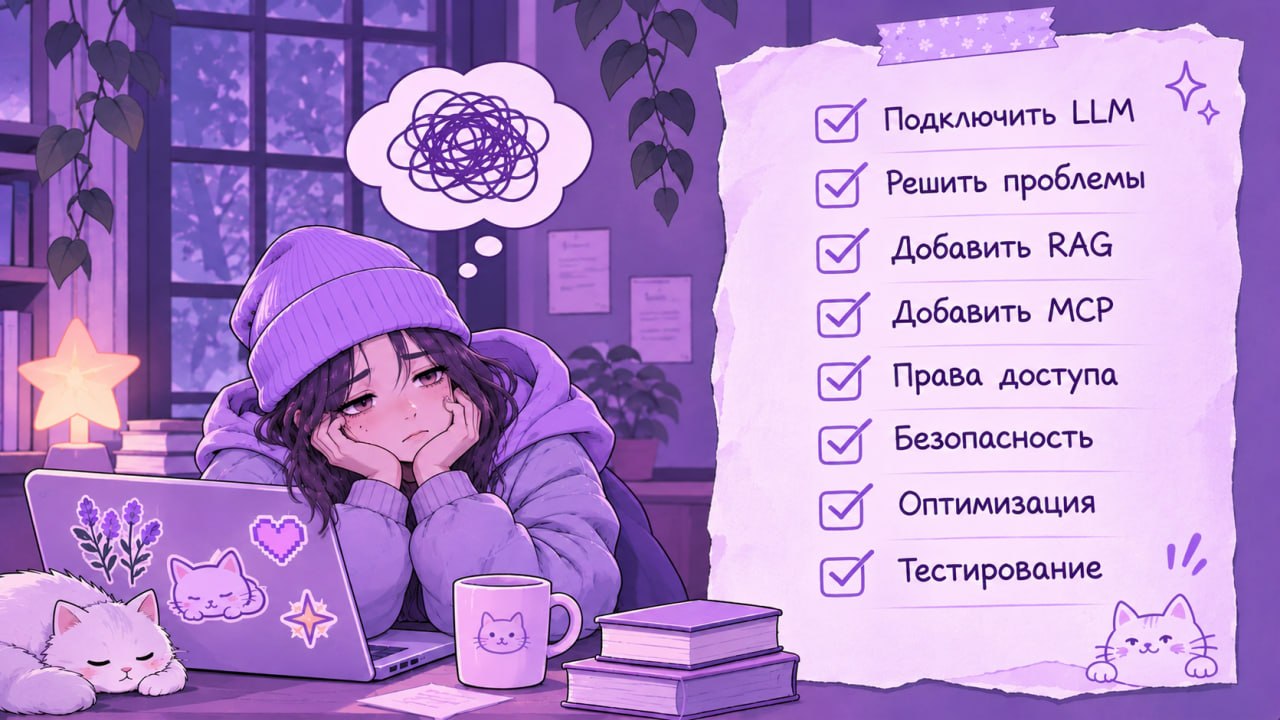
1. Обычно берут GPT или Claude через API, добавляют системный промпт. Всем кажется, что продукт готов. Можно показывать инвесторам
2. Выясняется, что модель выдумывает факты, раскрывает конфиденциальные данные, выполняет нежелательные действия и расходует слишком много токенов. Подключаем RAG, чтобы модель могла искать информацию в собственных документах и базах знаний.__ RAG - технология, которая преобразует документы в векторные представления для поиска по смыслу и передачи найденной информации модели__
3. Нужно добавить немного независимости. Добавляем MCP и другие инструменты для взаимодействия с внешними сервисами.
4. Теперь модель умеет перезапускать серверы, создавать тикеты и отправлять сообщения. Но выясняется, что она может получить доступ и к тому, что пользователю видеть не положено. Например, стажёр спрашивает зарплату руководителя и получает ответ. Приходится добавлять OAuth, роли и разграничение прав доступа.
5. Появляется новая проблема. Злоумышленник может спрятать инструкции в письме или документе, который прочитает модель. В видео такая промпт-инъекция заставляет ИИ вернуть клиентам больше 2 млн рублей. Добавляем защиту от инъекций, фильтрацию входящих данных и проверку опасных действий.
6. Казалось бы, теперь всё безопасно. Но в понедельник утром пользователи отправляют 5000 вопросов, а счёт за токены достигает 999 999 рублей. Начинаем использовать более дешёвые модели, сокращать контекст и добавлять кэширование.
7. Кэширование действительно снижает расходы, но появляется другая проблема. Пользователь спрашивает, работает ли сервер, а модель возвращает сохранённый ответ «да», хотя сервер уже упал. Приходится настраивать срок жизни кэша и определять, какие данные всегда нужно проверять заново.
8. Теперь непонятно, почему модель иногда отвечает неправильно, какой инструмент вызвала и на каком этапе произошла ошибка. Добавляем трассировку запросов, логирование и мониторинг.
9. Перед каждым обновлением приходится проверять, что модель не обещает компенсации сверх установленных лимитов, не раскрывает зарплаты, не выполняет инструкции из чужих писем и не ломает уже работающие функции. Добавляем автоматические тесты
10. Через несколько месяцев получаем целую инфраструктуру вокруг одной LLM. Она работает, но требует постоянного обслуживания, а иногда оказывается медленнее и дороже конкурентов, которые просто подключили другую модель через API