TurboQuant-GPU — сжатие KV-кэша языковых моделей на NVIDIA
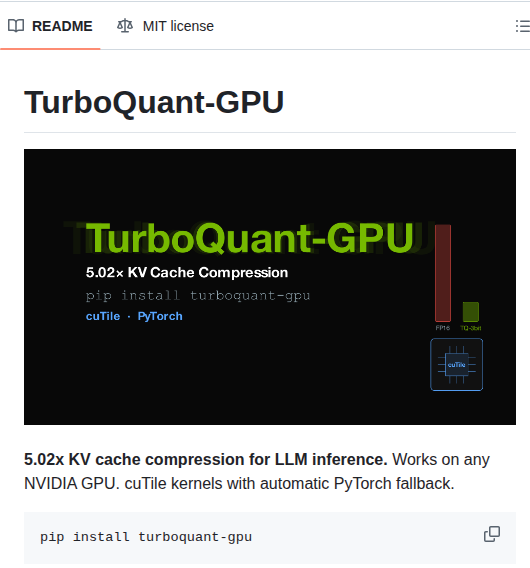
TurboQuant-GPU — библиотека для сжатия KV-кэша больших языковых моделей (LLM) на графических процессорах NVIDIA. Она предназначена для оптимизации использования памяти и повышения эффективности инференса LLM.
Проект применяет ортогональное вращение для приведения координат KV-кэша к приблизительно гауссовому распределению. Затем используется квантование Ллойда-Макса для достижения трёх бит на элемент. Для ключей применяется 2-битное MSE-квантование с 1-битной коррекцией смещения QJL, а для значений — 3-битное MSE-квантование. Эти операции сжатия выполняются в одном объединённом ядре для каждой головы внимания.
Для ускорения работы с GPU проект использует ядра cuTile, но также предусмотрен автоматический возврат к PyTorch, если cuTile недоступен. Поддерживается установка через pip. Для использования ядер cuTile требуется драйвер CUDA 13.0+.
https://github.com/DevTechJr/turboquant-gpu | 308 звёзд
#сервисы