Qwen-TTS Studio — локальный синтез речи с GGUF-моделями
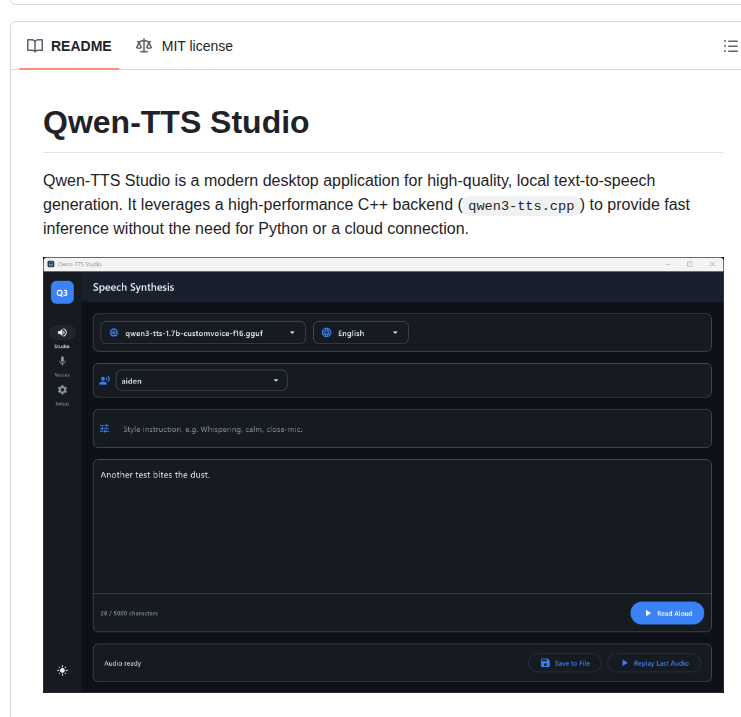
Qwen-TTS Studio — кроссплатформенное настольное приложение для локальной генерации речи из текста. Оно использует высокопроизводительный C++ бэкенд для быстрого инференса без Python или облачного подключения. Приложение предназначено для пользователей, которым требуется синтез речи без использования облачных сервисов.
Возможности и состав проекта
Приложение позволяет создавать собственные голосовые пресеты путём клонирования голоса из короткого аудиоклипа. Встроенная функция Voice Lab даёт возможность морфировать или усреднять эмбеддинги дикторов для создания уникальных голосов. Поддерживается управление стилем, тоном и эмоциями с помощью инструкций на естественном языке, если это предусмотрено моделью.
Начало работы и требования
Для работы Qwen-TTS Studio требуются GGUF-модели, которые можно загрузить при первом запуске или вручную разместить в указанной директории. Приложение поддерживает Windows и Linux, а также может использовать ускорение NVIDIA CUDA при наличии соответствующего оборудования. Интерфейс адаптируется к возможностям загруженной модели.
Ограничения и выбор сценария
Функции клонирования и управления стилем зависят от загруженной модели. Готовые CUDA-пакеты различаются: system использует установленный runtime, bundled включает необходимые DLL. Локальный инференс не отменяет первоначальной загрузки весов; условия моделей и права на используемый голос проверяются отдельно.
Лицензия и условия использования
GitHub определяет лицензию репозитория как MIT. Перед использованием и распространением проверьте полный текст LICENSE и отдельные условия зависимостей, данных или моделей: лицензия репозитория не заменяет их лицензии.