llm.codes — преобразование динамической документации в Markdown
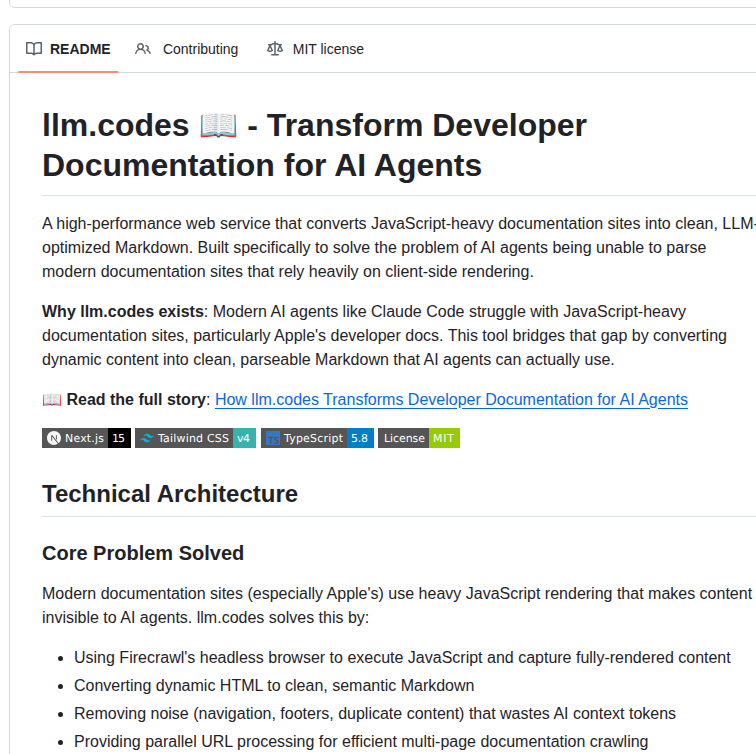
llm.codes — веб-сервис для преобразования документации, который оптимизирует контент веб-сайтов с интенсивным использованием JavaScript в чистый Markdown. Он предназначен для обработки моделями искусственного интеллекта. Сервис решает проблему неспособности ИИ-агентов эффективно парсить современные динамические документационные ресурсы, делая их содержание доступным для анализа.
Возможности и состав проекта
Сервис использует Firecrawl или саморазмещенный Playwright для выполнения JavaScript и захвата полностью отрисованного содержимого. llm.codes конвертирует динамический HTML в семантический Markdown, удаляя навигационные элементы, футеры и дублирующийся контент, что позволяет экономить токены контекста ИИ. Проект поддерживает параллельную обработку до 10 URL-адресов одновременно и имеет кэширование на 30 дней на базе Redis.
Начало работы и требования
Для запуска llm.codes требуются Node.js 24+ и pnpm 10+. В качестве поставщика скрапинга по умолчанию используется Firecrawl API, для которого необходим ключ. Альтернативно можно использовать саморазмещенный Playwright. Проект распространяется под лицензией MIT.
Ограничения и выбор сценария
Firecrawl — внешний сервис с собственным API, тогда как Playwright требует своего Chromium и ресурсов сервера. Преобразование страницы может потерять контекст, таблицы или интерактивные примеры; Markdown следует сверять с оригиналом. Кэш не гарантирует актуальность быстро обновляемой документации.
Лицензия и условия использования
GitHub определяет лицензию репозитория как MIT. Перед использованием и распространением проверьте полный текст LICENSE и отдельные условия зависимостей, данных или моделей: лицензия репозитория не заменяет их лицензии.