Open-source
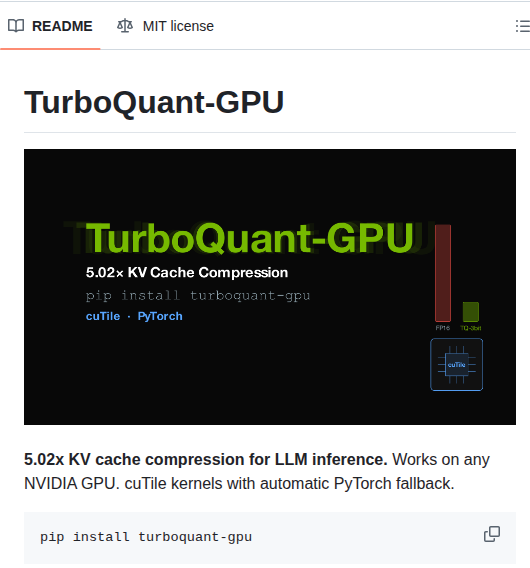
TurboQuant-GPU — сжатие KV-кэша языковых моделей на NVIDIA
22.10.2026
TurboQuant-GPU — библиотека для сжатия KV-кэша больших языковых моделей (LLM) на графических процессорах NVIDIA. Она предназначена для оптимизации использования памяти и повышения эффективности инференса LLM. Возможности и состав проекта Проект применяет ортогональное вращение для приведения...